
Ce que nous avons appris du premier défi FREUID
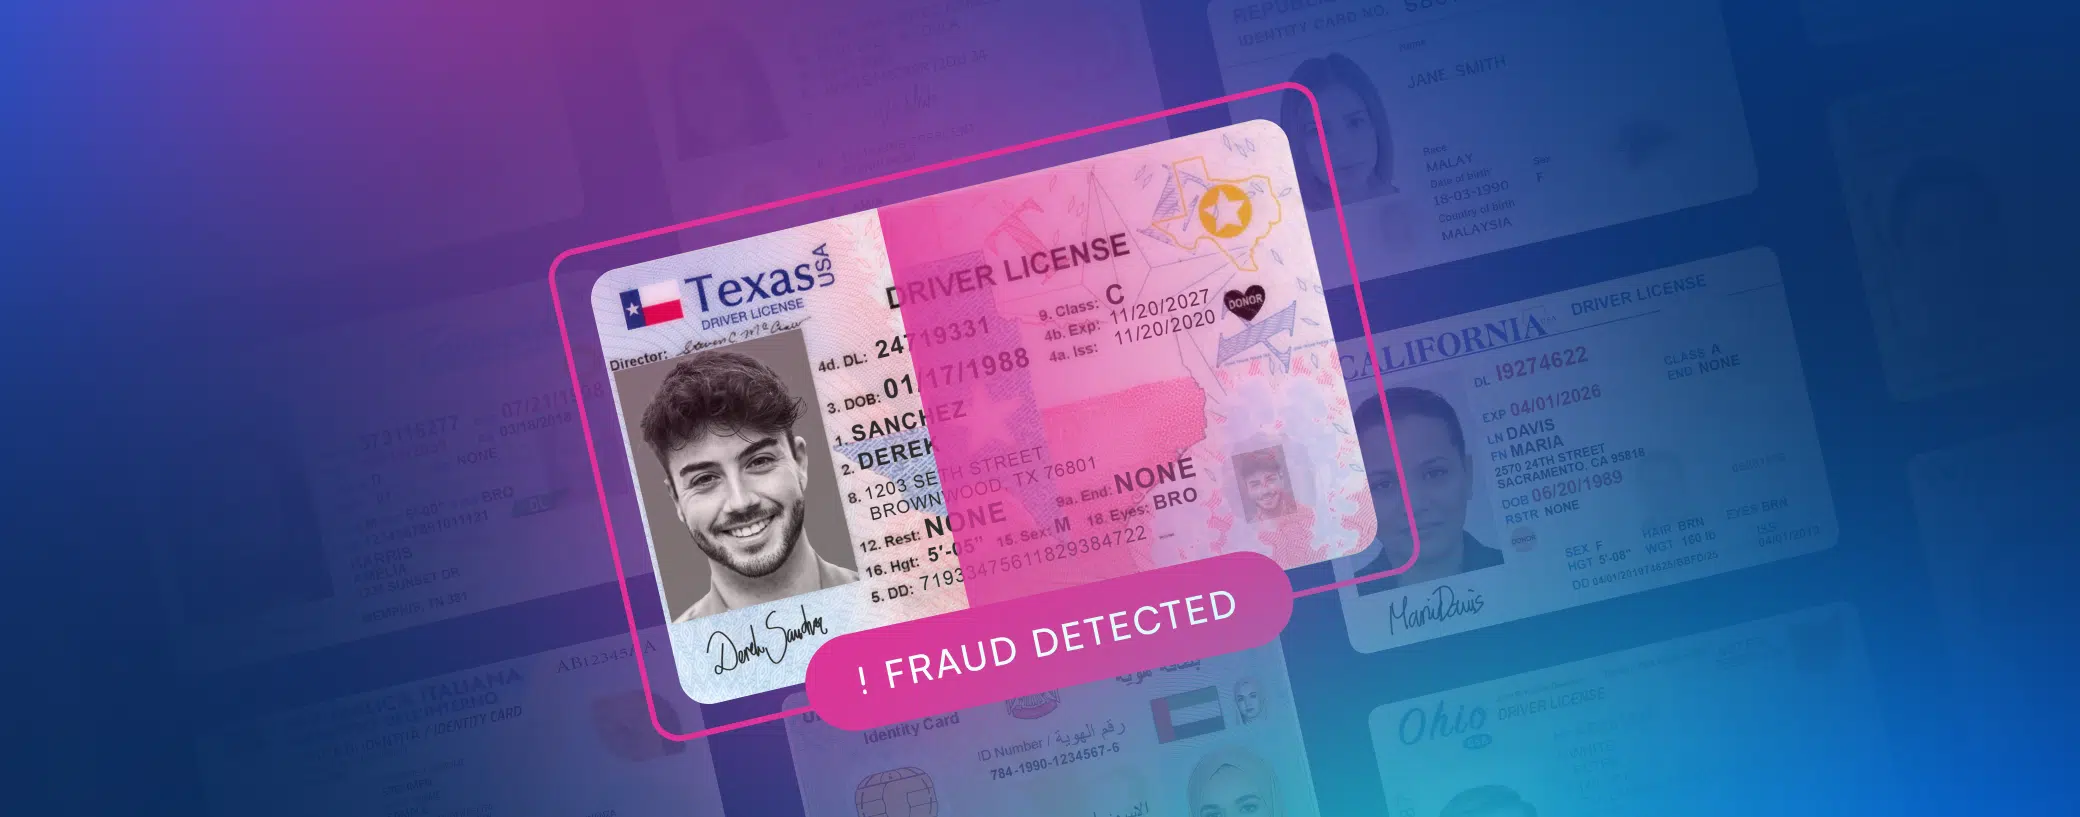
Lorsque nous avons lancé le FREUID Challenge en début d’année, notre objectif n’était pas simplement d’organiser un énième concours d’apprentissage automatique. Nous souhaitions plutôt tester une idée.
Un défi académique ouvert pourrait-il contribuer à faire évoluer la détection de la fraude documentaire au-delà des critères de référence statiques, pour s’orienter vers une évaluation des performances des modèles face aux changements de distribution auxquels ils sont confrontés dans le monde réel ?
Aujourd'hui, alors que le premier défi touche à sa fin, je pense que la réponse est oui ; et nous avons constaté que la communauté scientifique est elle aussi impatiente de s'attaquer à ce problème.
Plus de 300 participants, représentant 266 équipes, ont soumis plus de 4 100 modèles et expériences tout au long du concours. Des chercheurs du monde entier ont exploré différentes approches pour détecter la fraude documentaire tout en travaillant sur la base d'un même critère de référence, créant ainsi un niveau de transparence souvent difficile à atteindre dans le domaine de la détection de la fraude commerciale.
Élaborer de meilleurs critères de référence
Les tests de performance traditionnels en matière d’apprentissage automatique partent du principe que la distribution des données reste relativement stable. Or, la fraude ne fonctionne pas ainsi. De nouveaux modèles de documents apparaissent. Les technologies de capture mobile évoluent. Les appareils photo s’améliorent. Les processus de traitement d’images changent. L’IA générative réduit sans cesse les obstacles à la création de documents frauduleux extrêmement convaincants.
En production, les modèles sont constamment exposés à des données différentes de celles sur lesquelles ils ont été entraînés.
Le défi ne consistait pas simplement à obtenir le meilleur score possible sur un ensemble de données donné. Il s'agissait plutôt d'encourager des approches capables de s'appliquer au-delà des attaques actuelles.
En effet, un modèle qui fonctionne bien dans des conditions contrôlées peut rencontrer des difficultés lorsqu'il est confronté à des types de documents inconnus, à des environnements de capture inédits, à de nouveaux environnements d'imagerie ou à des techniques d'attaque totalement nouvelles. La mise au point de systèmes de détection des fraudes capables de s'adapter à ces changements, plutôt que de se contenter de mémoriser des modèles issus de données historiques, reste l'un des défis les plus importants auxquels sont confrontés tant les chercheurs que le secteur.
L'importance de la collaboration
L'organisation de FREUID a permis de réunir des équipes issues des domaines de l'ingénierie, de l'apprentissage automatique, du droit, de la science des données et de la recherche, tout en nouant de nouvelles collaborations avec des universités et des groupes de recherche en Croatie, en Italie et au-delà.
Ce qui est peut-être encore plus passionnant, c’est de voir la communauté scientifique dans son ensemble se pencher sur ce problème. Nous avons particulièrement hâte de prendre connaissance des rapports techniques des équipes les plus performantes. Les chercheurs ont abordé ce défi sous différents angles, et comprendre non seulement quelles solutions ont fonctionné, mais aussi pourquoi elles ont fonctionné, contribuera à faire progresser le domaine dans son ensemble bien au-delà d’un simple classement.
Ce n'est qu'un début
Même si le concours touche à sa fin, le travail, lui, est loin d'être terminé. L'ensemble de données FREUID continuera à servir de base aux futures recherches universitaires, et nous prévoyons d'ores et déjà de nouvelles publications et collaborations qui s'appuieront sur les résultats obtenus dans le cadre de ce défi.
Le paysage de la fraude ne cessera d'évoluer. Il en va de même pour la manière dont nous l'évaluons.
Le mois prochain, nous rencontrerons les équipes participantes lors de la conférence IJCAI–ECAI à Brême. Nous espérons que les échanges lancés par FREUID se poursuivront bien au-delà de la fin du concours.
Si la première édition du FREUID Challenge a bien démontré une chose, c'est que la résolution du problème du benchmarking nécessitera une collaboration continue entre le monde de l'industrie et celui de la recherche universitaire. C'est précisément cette communauté que nous espérons continuer à développer.