La discipline des données : la clé pour libérer le véritable potentiel de l'IA


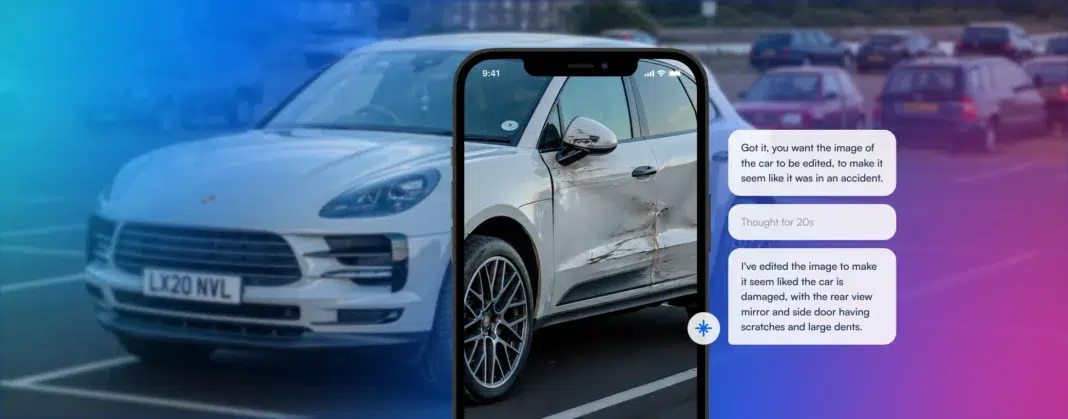
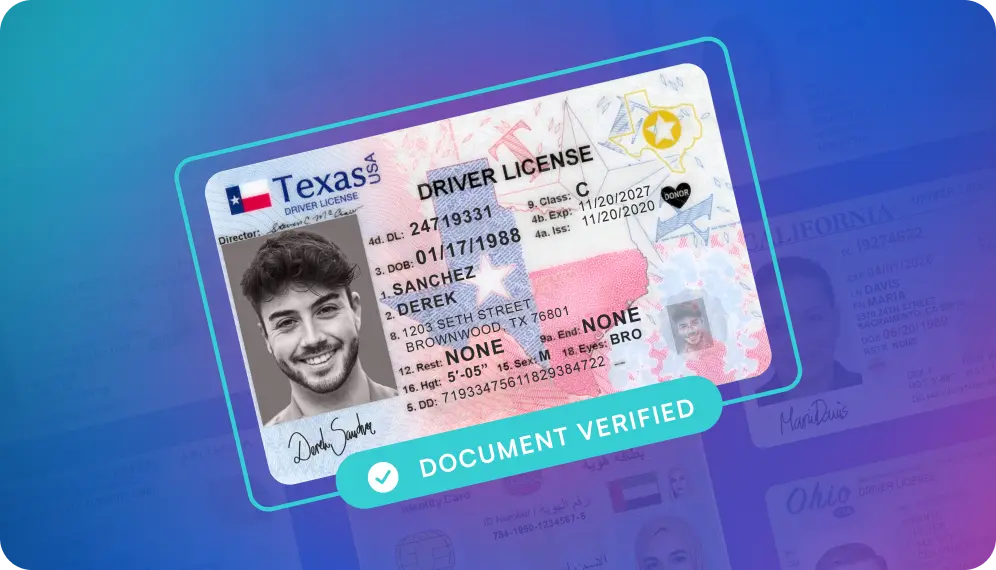
La nature même du commerce numérique exige que les processus d’inscription et de paiement soient fluides et simples pour les utilisateurs. Dans le même temps, la facilité d’utilisation ne peut pas primer totalement sur la prévention de la fraude. Trouver le juste équilibre entre ces deux aspects s'avère être une tâche difficile pour les entreprises en ligne, d'autant plus que les fraudeurs utilisent l'intelligence artificielle pour créer des documents d'identité synthétiques d'apparence très authentique, qui peuvent présenter de légères modifications, difficiles à détecter, par rapport à leurs équivalents réels.
La vérification d’identité numérique et le traitement des paiements exigent non seulement de la rapidité, mais aussi de la précision et de la sécurité. Chez Microblink, nous y parvenons en exploitant de vastes quantités de données de haute qualité pour entraîner nos modèles d’apprentissage automatique. Mais nous ne nous contentons pas de collecter des données : celles-ci sont soigneusement sélectionnées, traitées et continuellement affinées afin de garantir que nos solutions BlinkCard et BlinkID restent à la pointe de la technologie. De l’acquisition à l’annotation, chaque étape de notre pipeline de données est conçue pour améliorer les performances, détecter la fraude et prendre en charge un éventail toujours plus large de documents internationaux.
Acquisition de données – Le fondement de la vérification d'identité et de documents
La qualité d'un modèle dépend de celle des données qui lui sont fournies ; c'est pourquoi l'acquisition de données joue un rôle essentiel dans l'IA. Il faut un volume important d'images variées de documents tels que des cartes de crédit, des passeports et des cartes d'identité pour entraîner efficacement les modèles d'apprentissage automatique. Nous combinons deux approches :
- Collecte de données – Images réelles de documents existants dans le monde réel, basées sur des versions mondiales en constante évolution.
- Génération de données synthétiques – Exploiter l'IA pour procéder à la rétro-ingénierie d'échantillons répondant à des besoins spécifiques en matière d'entraînement de modèles.
L'importance de la conformité
Lorsqu'on traite un volume aussi important de données, il est essentiel de respecter l'ensemble des lois relatives à la protection de la vie privée des utilisateurs, telles que le RGPD.
Tous les utilisateurs ont également la possibilité de refuser la collecte de données et de demander la suppression de leurs données à tout moment. Nous appliquons des pratiques strictes de minimisation des données afin de n'utiliser que celles qui sont nécessaires à l'entraînement des modèles et à l'amélioration de nos produits.
Notre cadre de conformité prévoit des audits et des évaluations réguliers afin de garantir que nos processus de traitement des données soient conformes aux exigences réglementaires en constante évolution. Nous travaillons également en étroite collaboration avec des experts juridiques et en sécurité afin de respecter les meilleures pratiques en matière de gouvernance des données. En accordant la priorité à la confidentialité et à la sécurité, nous nous acquittons non seulement de nos obligations légales, mais nous renforçons également la confiance de nos utilisateurs et de nos partenaires.
Traitement des données : nettoyage et structuration pour les modèles d'apprentissage automatique
Les données brutes sont rarement exploitables sous leur forme initiale. Avant de pouvoir être utilisées pour l’entraînement, nos données sont soumises à plusieurs étapes de traitement. Le prétraitement permet d’éliminer les données de mauvaise qualité ou non pertinentes afin de garantir une grande précision. Vient ensuite la catégorisation des données, au cours de laquelle une équipe spécialisée analyse chaque document, identifie les éléments clés et structure correctement les données. Une étape d’annotation est ensuite réalisée : des experts attribuent des étiquettes à des champs spécifiques des documents, tels que les noms, les adresses et les photos, afin d’entraîner les modèles d’apprentissage automatique avec précision. La détection des fraudes joue un rôle essentiel dans notre processus : nos experts en documents examinent minutieusement les documents pour repérer ceux qui ont été falsifiés ou qui sont des faux, garantissant ainsi que nos modèles puissent détecter les activités frauduleuses dans des applications concrètes.
Au-delà de ces étapes fondamentales, Microblink utilise des méthodologies supplémentaires pour affiner et structurer davantage les données. Un tri préalable est effectué afin d’éliminer les images inutilisables et de détecter les objets d’intérêt dans les images. Nous déterminons également la pertinence et les catégories générales de tous les documents et images capturés. La catégorisation des données permet de prendre en compte les variations régionales et les changements de format, ce qui améliore la capacité d’adaptation du modèle.
Le facteur humain
Il convient également de souligner que notre équipe d'annotateurs est entièrement interne, ce que ne peuvent pas affirmer de nombreux autres prestataires, qui sous-traitent ces tâches. Il s'agit d'experts capables de repérer les altérations ou différences les plus subtiles dans les documents synthétiques frauduleux et d'enregistrer ces données, qui sont ensuite réinjectées dans nos modèles d'apprentissage automatique et utilisées pour détecter avec encore plus de précision les signes de fraude.
Des techniques d'annotation complètes, telles que l'utilisation de cadres de sélection pour mettre en évidence les champs critiques des documents et la transcription du texte dans des formats structurés, améliorent l'efficacité de l'apprentissage automatique. La reconnaissance des schémas de fraude permet à notre système de recouper les schémas frauduleux connus, renforçant ainsi nos mécanismes de prévention de la fraude. Enfin, les mises à jour continues des modèles garantissent que les données traitées et validées sont intégrées dans notre pipeline d’apprentissage par apprentissage automatique, ce qui permet à nos solutions de rester en avance sur l’évolution des normes en matière de documents.
Apprentissage automatique basé sur les données : entraîner la prochaine génération de modèles
Notre équipe d'apprentissage automatique développe et affine en permanence des modèles afin de prendre en charge de nouveaux types de documents et d'améliorer la précision. Ce processus implique l'analyse de nouvelles versions de documents pour identifier les changements de format, de caractéristiques de sécurité et d'emplacement du texte. Lorsque nous ne disposons pas d’échantillons réels, nous générons des documents synthétiques aléatoires pour faciliter l’entraînement des modèles. Une fois les données annotées et structurées, elles sont utilisées dans le processus d’entraînement et de déploiement des modèles, ce qui permet à nos modèles d’apprentissage automatique d’apprendre à reconnaître, extraire et vérifier efficacement les données des documents.
Les atouts de Microblink : qualité, expertise et évolutivité
Ce qui nous distingue, c’est notre expertise approfondie du domaine et nos capacités internes. Contrairement aux prestataires externes, nous maîtrisons l’ensemble du pipeline de données — de la collecte à l’annotation —, garantissant ainsi la cohérence, la précision et la sécurité des données. Cela nous permet d’itérer rapidement, de nous adapter à de nouveaux types de documents et d’évoluer efficacement tout en respectant les normes de qualité les plus élevées. Alors que nous continuons à innover, les données resteront au cœur de notre technologie. Qu'il s'agisse d'améliorer la détection des fraudes, d'étendre la prise en charge des documents à l'échelle mondiale ou d'automatiser le traitement des données, notre engagement à exploiter les données de manière responsable garantit que BlinkCard et BlinkID offrent les meilleures expériences possibles, tant aux entreprises qu'aux utilisateurs. Si vous souhaitez en savoir plus sur la manière dont Microblink peut aider votre entreprise à lutter contre la fraude et à satisfaire vos clients, contactez-nous dès aujourd’hui.